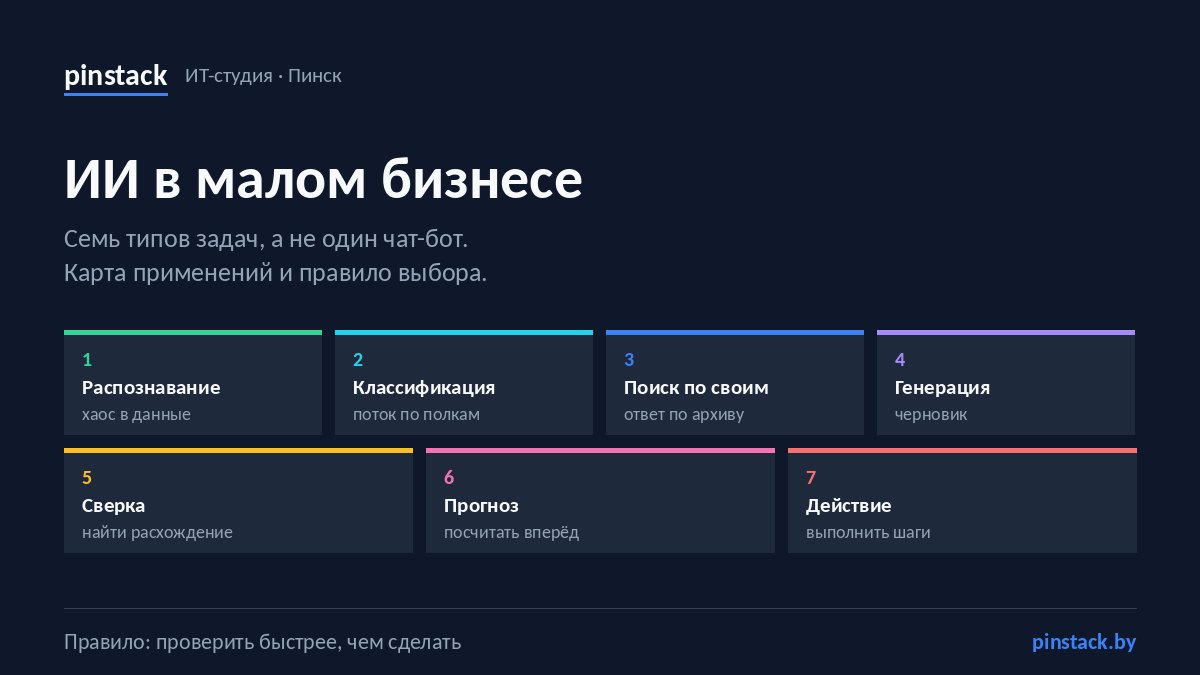
Искусственный интеллект в малом бизнесе не равен чат-боту, который пишет тексты. Генерация текста это один тип операции из семи, и по деньгам далеко не главный. Остальные шесть закрывают ту рутину, на которой у небольшой фирмы горят часы: разбор входящих документов, сверка, поиск по своему архиву, классификация заявок, расчёт заказа, автоматические действия по итогам звонка.
Выбор задачи решается одним правилом, и оно жёстче, чем кажется:
Если проверить результат не быстрее, чем сделать работу самому, экономии не будет.
Цифры: пользуются многие, меняется мало что
Беларусь. В феврале и марте 2026 года агентство МАСМИ опросило 500 негосударственных компаний в городах от 100 тысяч жителей и в Минской области. Результат: 21,6 % используют ИИ регулярно (ежедневно и чаще), ещё 27,8 % используют иногда, 18 % планируют внедрить, 32,4 % не используют и не планируют. Попутно выяснилось, что доля компаний со специализированной CRM выросла с 16 % в 2021 году до 64,6 % в 2026, а IP-телефония с 23 % до 44 % (данные исследования).
США. Бюро переписи ведёт двухнедельное обследование Business Trends and Outlook Survey. С 14 декабря 2025 по 3 мая 2026 года доля фирм, применяющих ИИ в производстве товаров и услуг, колебалась в пределах от 17 до 20 %, на май 2026 года это 19,8 %. В компаниях от 250 человек 37 %, в микрофирмах до 4 человек меньше 20 %. По отраслям разброс от 39,7 % в информационном секторе до 14 % в рознице (U.S. Census Bureau).
Прямое сравнение двух цифр некорректно: у американцев меряется применение в производстве товаров и услуг за двухнедельное окно, у белорусов регулярное использование вообще, и выборка ограничена крупными городами. Но порядок величины один, и данных, подтверждающих драматическое отставание белорусского бизнеса по факту использования ИИ, нет.
Отставание в другом. Опрос 530 белорусских компаний, представленный на ТИБО в 2024 году доктором экономических наук БГЭУ Кириллом Рудым, дал ключевую цифру: более 70 % респондентов сказали, что ИИ затрагивает не более 10 % процессов в их компании (Экономическая газета). Основное направление применения: обработка текстовой информации. Данные двухлетней давности, свежее замера по глубине проникновения нет.
Третий слой добавляет исследование MIT: из корпоративных пилотов генеративного ИИ 95 % не дают измеримого эффекта на финансовый результат. Методология: 52 интервью, 153 опроса руководителей, разбор более 300 публичных инициатив, с января по июнь 2025 года. Там же цифра, которую почти не цитируют: внедрение готового решения от внешнего поставщика доходит до промышленной эксплуатации в 66 % случаев, а собственная разработка в 33 % (The GenAI Divide: State of AI in Business 2025).
Источник | Кого спрашивали | Что показал |
|---|---|---|
МАСМИ, февраль и март 2026 | 500 компаний Беларуси | 21,6 % регулярно, 27,8 % иногда |
Бюро переписи США, май 2026 | выборка фирм США | 19,8 % применяют в производстве |
БГЭУ, 2024 | 530 компаний Беларуси | у 70 % охвачено до 10 % процессов |
MIT NANDA, 2025 | корпоративные пилоты | 95 % без эффекта на прибыль |
Четыре замера складываются в одну картину: инструмент взяли многие, в процессы встроили единицы.
Из соотношения 66 и 33 следует вывод, неприятный для нас как для подрядчика: заказывать собственную ИИ-разработку на старте рискованнее, чем взять готовое и настроить. Оговорка: это доли в выборке интервью MIT, а не установленная закономерность для малого бизнеса.
Почему в голове осталась одна функция из семи
Первым массовым интерфейсом к языковым моделям оказался чат, и этот опыт закрепился как «что такое ИИ». Между тем чат это интерфейс, а не функция. Та же модель за тем же API извлекает суммы из скана накладной, проставляет категорию входящему обращению, находит расхождение между заказом и поставкой. Пользователь не видит ни диалога, ни «нейросети». Он видит, что в учётной системе сама появилась заполненная строка.
Заметьте, что фильтр спама, автоперевод страницы и шумоподавление в видеозвонке вы за ИИ не считаете именно потому, что они встроены в процесс, а не вынесены в отдельное окно. Правдоподобное объяснение разрыва между «пользуются 49 %» и «охвачено 10 % процессов» лежит здесь же.
Карта: семь типов задач
Полезнее делить не по инструментам, а по типу операции. Инструменты меняются каждые полгода, типы операций не менялись десятилетиями.
Обратите внимание на два последних столбца. Это разные вещи, и путать их дорого: быстрая проверка говорит, что задача выгодна, а низкая цена ошибки говорит, что её можно отпустить без присмотра.
# | Тип операции | Что делает | Проверить результат | Цена ошибки |
|---|---|---|---|---|
1 | Распознавание | превращает хаос в данные | секунды | зависит от того, что делают дальше |
2 | Классификация | раскладывает поток по полкам | секунды | низкая |
3 | Поиск по своим | отвечает по вашим документам | быстро, если есть ссылка на пункт | средняя |
4 | Генерация | делает черновик | быстро на типовом, долго на важном | низкая |
5 | Сверка | находит расхождения | секунды | низкая |
6 | Прогноз | считает вперёд | только временем | высокая |
7 | Действие | выполняет шаги сам | секунды | высокая, часто необратимая |
1. Распознавание: хаос превращается в данные
Самый недооценённый и самый денежный тип для небольшой фирмы. Модель берёт то, что нельзя положить в таблицу, и делает из этого строки.
Счета, акты и спецификации в PDF от поставщиков превращаются в позиции в учётной системе.
Рукописные заявки мастеров и путевые листы становятся электронными записями.
Запись планёрки превращается в протокол с поручениями и сроками.
Фото поддона на складе даёт список позиций и количество.
Показания счётчиков снимаются с фотографии.
Реквизиты из письма контрагента сами попадают в карточку.
Сюда же относится компьютерное зрение: распознавание номеров на въезде, отбраковка по внешнему виду, подсчёт единиц продукции. Другой класс моделей, работает давно и надёжно.
Проверка занимает секунды: сравнить распознанную сумму с суммой на бумаге быстрее, чем набрать её руками. Но цена ошибки определяется не распознаванием, а следующим шагом. Распознать накладную дёшево; списать по ней остатки со склада без подтверждения человеком дорого.
2. Классификация: поток раскладывается по полкам
Задача формулируется как «определи, к чему это относится».
Входящие письма распределяются по ответственным.
Заявки делятся на срочные и плановые.
Отзывы группируются по темам: доставка, качество, цена, персонал.
Обращения на польском, литовском, русском и белорусском попадают к тому, кто ответит.
Фотография изделия получает метку «брак» или «норма».
Тонкий момент: отбор резюме и оценка кандидатов сейчас зона, где регулирование пересматривается. Подробнее в разделе про ограничители.
3. Поиск по своим документам
Не поиск в интернете, а ответ по вашему архиву. Документы разбиваются на фрагменты, к вопросу подбираются нужные, модель отвечает строго по ним и даёт ссылку на источник.
«В каких действующих договорах есть автопролонгация и до какого числа надо успеть с уведомлением?»
«Что написано в паспорте на этот станок про интервал замены масла?»
«Как мы решали такую же поломку два года назад?»
Новый сотрудник задаёт вопросы по регламентам и не отвлекает бухгалтера двадцать раз в день.
Проверка быстрая ровно при одном условии: модель называет пункт или файл, откуда взяла ответ. Тогда убедиться значит открыть указанное место. Без ссылки на источник тот же ответ проверяется чтением всего документа, и вся выгода исчезает. Ссылка на источник здесь не украшение, а условие применимости.
Отдельная слабость этого типа: легко проверить, что найденное верно, и трудно проверить, что ничего не пропущено. Если модель нашла в архиве пять договоров с автопролонгацией, убедиться в каждом из пяти можно за минуты, а вот вопрос «а не было ли шестого» закрывается только сплошным просмотром. Для задач, где важна полнота, это ограничение надо учитывать заранее.
Для фирмы с архивом договоров за десять лет этот тип превращает мёртвый шкаф в рабочий инструмент.
4. Генерация: черновик, а не готовый результат
Тот самый известный тип, и его место скромнее, чем принято думать.
Окупается на массовых однотипных текстах: пятьсот карточек товара, переводы каталога, ответы на типовые обращения, черновики договоров из утверждённых шаблонов. Расчёт по этому случаю ниже.
Не окупается на единичных важных текстах. Коммерческое предложение ключевому клиенту вы всё равно перепишете, и время уйдёт то же самое. Один и тот же тип операции попадает по разные стороны правила проверки в зависимости от тиража.
5. Сверка: находит то, что человек пропускает
Класс, о котором почти не пишут. Здесь ИИ проверяет работу, уже сделанную человеком или системой.
Счёт от поставщика сверяется с условиями договора: не выросла ли цена молча.
Накладная сверяется с заказом: что недовезли.
Договор проверяется на пункты, которых нет в вашем стандарте.
Справочник в бухгалтерии сверяется со справочником в складской программе.
База клиентов проверяется на дубли, где один контрагент записан тремя способами.
Ценность в том, что расхождение либо есть, либо нет: проверка мгновенная, а найденные ошибки стоят денег напрямую.
6. Прогноз и расчёт расписаний
Сколько заказать, кто из клиентов собирается уйти, как загрузить мастеров на неделю, в каком порядке объехать точки.
Уточнение по существу: маршруты, расписания и раскрой это не нейросети, а классические алгоритмы оптимизации. Их часто продают под вывеской «ИИ», хотя математике внутри лет пятьдесят. Работают они надёжнее языковых моделей, и результат у них проверяется сразу: километраж маршрута видно в момент построения.
А вот собственно прогноз проверяется только временем. Вы узнаете, что модель ошиблась, через месяц, когда склад уже забит. Поэтому прогнозы запускают параллельно со старым способом хотя бы на один цикл.
7. Действие: система делает шаги сама
Модель не отвечает, а выполняет последовательность: после звонка заполняет карточку в CRM, ставит задачу, отправляет типовое предложение; разбирает почту и создаёт заявки; собирает отчёт из трёх систем; следит за ценами поставщиков.
Проверить результат здесь легко: посмотреть, что заполнилось. Проблема в другом: ошибочно отправленное письмо уже ушло. Поэтому для необратимых действий держат подтверждение человеком, а автоматически выполняют только обратимое.
Правило проверки: главный фильтр
Экономия от ИИ на конкретной задаче считается так:
Экономия = Т_ручное − ( Т_генерации + Т_проверки + Доля_ошибок × Т_исправления )

где
  Т_ручное       сколько занимает задача сейчас
  Т_генерации    сколько ждём ответа модели (обычно секунды)
  Т_проверки     сколько занимает проверка результата
  Доля_ошибок    какая часть результатов требует правки
  Т_исправления  сколько занимает правка одного результата
Поскольку время генерации близко к нулю, условие выгоды упрощается до одной строки:
Т_проверки + Доля_ошибок × Т_исправления должно быть заметно меньше Т_ручное.
Проверим на трёх задачах.
Параметр | Карточка товара | Условия из договора | Расчёт сметы |
|---|---|---|---|
Вручную | 12 мин | 30 мин | 45 мин |
Ответ модели | 0,5 мин | 4 мин | 3 мин |
Проверка | 3 мин | 5 мин | 40 мин |
Доля правок × время правки | 0,2 × 5 = 1 мин | 0,15 × 3 = 0,45 мин | 0,4 × 8 = 3,2 мин |
Итого с ИИ | 4,5 мин | 9,45 мин | 46,2 мин |
Результат | минус 62,5 % | минус 68,5 % | медленнее на 1,2 мин |
Первые два случая выигрышные, третий проигрышный, и разница между ними не в сложности документа. Смета не сложнее договора, а объём текста в ней меньше.
Условия из договора. Поставщик прислал двенадцать страниц, нужно выписать срок, порядок оплаты, штрафы за просрочку, автопролонгацию, условия расторжения. Прочитать и выписать вручную это полчаса. Модель отвечает за минуты, и ключевое здесь то, что она указывает пункты: «одностороннее изменение цены, пункт 5.3». Проверка сводится к тому, чтобы открыть шесть названных пунктов и прочитать их. Пять минут.
Расчёт сметы. Пятнадцать позиций с материалами и трудозатратами, на выходе сумма. Модель считает за три минуты. А дальше начинается неприятное: сумма не указывает ни на что. Чтобы принять цифру 8 400 рублей, надо убедиться, что верны цены по каждой позиции и объёмы, то есть пройти всю смету заново, только глазами. Сорок минут. Плюс ошибки в арифметике и в подстановке цен встречаются часто.
Отсюда формулировка правила точнее, чем «сложная задача против простой»:
Быстро проверяется то, на что можно указать пальцем в исходнике. Медленно проверяется то, что получено преобразованием.
Извлечь, найти, классифицировать, сопоставить: у результата есть адрес в документе, и проверка это переход по адресу. Посчитать, спрогнозировать, вывести заключение: адреса нет, и проверка это повторение преобразования. Первое ИИ ускоряет в разы, второе не ускоряет вовсе.
Вернёмся к каталогу. На 500 позиций экономия составит 3 750 минут, то есть 62,5 часа: было 100 часов работы, стало 37,5.
Переведём в деньги. Средняя начисленная зарплата по Брестской области в июне 2026 года составила 2 745 рублей (БЕЛТА со ссылкой на Белстат). С отчислениями в ФСЗН 34 % и взносом в Белгосстрах полная стоимость для нанимателя выше примерно на 34,6 %. При 168 рабочих часах в месяце час такого сотрудника обходится в 2 745 × 1,346 ÷ 168 = 21,99 рубля. Итого 62,5 × 21,99 = 1 375 рублей на одном каталоге.
Теперь структура затрат. Обработка тех же 500 карточек через API обошлась бы примерно в 0,45 доллара по тарифу 0,30 и 2,50 доллара за миллион входящих и исходящих токенов (прайс Gemini API); расчёт при 500 входных и 300 выходных токенах на карточку. По курсу Нацбанка 3,0197 рубля за доллар это 1,36 рубля против 1 375 рублей сэкономленного времени.
Вычисления стоят около одной тысячной от эффекта. Деньги уходят не на токены, а на настройку, проверку и переделку процесса. Любой расчёт окупаемости, построенный на стоимости подписки, считает не ту величину.
Вторая ось: сколько стоит ошибка
Правило проверки отвечает на вопрос «выгодно ли». Второй вопрос: можно ли отпускать без присмотра. Здесь работают частота задачи и цена одной ошибки.
Ошибка дешёвая | Ошибка дорогая | |
|---|---|---|
Задача частая | автоматизировать, вычитка беглая и сплошная | автоматизировать, но финальное действие за человеком |
Задача редкая | не трогать, настройка не окупится | делать руками, ИИ максимум как второе мнение |
Обратите внимание: в левой верхней клетке вычитка всё равно сплошная, просто быстрая. Именно она заложена в расчёт выше как 3 минуты на карточку. Выборочный контроль в этой клетке возможен только после того, как вы измерили долю ошибок на первой сотне и убедились, что она стабильна.
Приём для правой верхней клетки: модель готовит, человек нажимает кнопку. Одно движение мыши вместо двадцати минут работы, ответственность остаётся на человеке.
Что показали контролируемые эксперименты
Колл-центр, 5 179 сотрудников поддержки. Эрик Бриньолфсон, Даниэль Ли и Линдси Реймонд измерили эффект от ИИ-подсказок. Средний рост числа решённых обращений в час составил 14 %. Но внутри среднего прячется главное: у новичков и слабых сотрудников прирост 34 %, у опытных эффект минимальный. Механизм авторы объясняют так: модель распространяет практики сильных сотрудников на остальных (NBER Working Paper 31161, опубликовано в Quarterly Journal of Economics в 2025 году).
Консультанты, 758 человек. Фабрицио Делль'Аква с коллегами из Гарвардской школы бизнеса провели полевой эксперимент. На 18 задачах внутри «границы возможностей» модели участники с ИИ выполнили на 12,2 % больше задач, на 25,1 % быстрее и заметно качественнее. А на задаче за пределами этой границы участники с ИИ давали правильное решение на 19 процентных пунктов реже, чем работавшие без него.
Отсюда вывод: ИИ подтягивает слабых и меньше помогает сильным. Эффект выше там, где много новичков и текучка: розница, поддержка, продажи, обработка заявок. Для микрофирмы из трёх опытных людей прирост качества решений будет скромнее рекламного. Это перенос результата с колл-центра на другие роли, то есть допущение. Экономия часов на рутине из первой части статьи от этого не зависит: там речь про механическую работу, а не про качество суждений, и 62,5 часа на каталоге освободятся у кого угодно.
Три ограничителя, специфичных для Беларуси
Ограничитель первый: персональные данные
Национальный центр защиты персональных данных высказался прямо: загрузка персональных данных в иностранный ИИ-сервис квалифицируется как трансграничная передача. Если реальной возможности выбора у субъекта нет, такая обработка недопустима. Центр отдельно предупреждает о риске утечки коммерческой тайны через облачные ИИ-решения (разъяснения НЦЗПД, ноябрь 2025).
Дальше арифметика юрисдикций. Передавать персональные данные без дополнительного разрешения можно в государства, обеспечивающие надлежащий уровень защиты: участники Конвенции Совета Европы 1981 года и страны Евразийского экономического союза. Перечень утверждён приказом директора НЦЗПД от 15 ноября 2021 года № 14 и дополнен приказом от 26 декабря 2022 года № 114 (НЦЗПД о трансграничной передаче, о дополнении перечня).
Соединённых Штатов в этом перечне нет. А серверы большинства известных ИИ-сервисов находятся именно там.
Здесь важно точно понимать конструкцию закона. Статья 9 Закона от 7 мая 2021 года № 99-З сформулирована как запрет: трансграничная передача запрещается, если в иностранном государстве не обеспечивается надлежащий уровень защиты. Далее идёт закрытый перечень из семи исключений (текст закона на Pravo.by). Для обычного бизнеса практически применимы два: согласие субъекта при условии, что он проинформирован о рисках, и передача для исполнения договора с самим субъектом. Плюс отдельным пунктом разрешение уполномоченного органа.
Это не разрешительный порядок, где достаточно обосновать. Это запрет с исключениями, и бремя доказывания на вас.
С согласием работников есть отдельная сложность, которую Центр называет сам: работник не может отказаться без последствий, поэтому его согласие не считается свободным.
Цена вопроса. Статья 23.7 КоАП: несоблюдение мер защиты персональных данных для юридического лица от 20 до 50 базовых величин, умышленное незаконное распространение до 200 базовых (разбор на сайте НЦЗПД). При базовой величине 45 рублей с 1 января 2026 года (Совет Министров) это от 900 до 2 250 рублей и до 9 000 рублей соответственно.
Закон меняется прямо сейчас, и в две стороны. По состоянию на сентябрь 2026 года законопроект уже внесён в Совет Министров, в парламент по плану должен поступить в ноябре 2026 года. С одной стороны, директор НЦЗПД Андрей Гаев говорит о новой норме про юридически значимые решения, принятые исключительно автоматизированной обработкой без участия человека: человек должен быть проинформирован и иметь возможность таким процедурам не подвергаться (БЕЛТА, Onliner). С другой стороны, в том же проекте перечень оснований обработки без согласия предлагается расширить, в том числе отказаться от требования согласия на предварительных этапах подбора кандидатов на работу (разбор со ссылкой на БЕЛТА, сентябрь 2026).
Читается это так: получить резюме и обработать его станет проще, а вот принимать по нему решение без человека станет сложнее. Если вы строите автоматический отбор кандидатов, автоматическое одобрение рассрочки или автоматическое расторжение договора, - закладывайте участие человека в финальном решении сразу. Финальный текст закона не опубликован, поэтому строить схему на прогнозе его содержания преждевременно.
Это не юридическая консультация. Перед внедрением проверьте конкретную конфигурацию с юристом.
Ограничитель второй: доступ
Беларусь не входит в перечень поддерживаемых стран и территорий OpenAI. В документации прямо сказано, что доступ из неподдерживаемых стран может привести к блокировке или приостановке учётной записи (OpenAI Supported countries). В списке стран, где доступен Gemini API, Беларуси также нет (Available regions).
Легальные варианты, которые остаются:
Сервисы, физически размещающие данные в странах перечня НЦЗПД. Если провайдер хранит и обрабатывает данные в государстве ЕАЭС или в стране Конвенции 1981 года, разрешение Центра не требуется. Условие работает при одном: страна размещения должна быть зафиксирована в договоре, а не предполагаться. Доступность конкретного провайдера для резидентов Беларуси и регион хранения проверяйте до подписания.
Модели на собственном оборудовании. Данные не покидают офис, вопрос трансграничной передачи снимается целиком.
Работа только с обезличенными данными. Описания товаров, тексты для сайта, техническая документация, код: персональных данных там нет, ограничения не применяются. Самый простой путь, и им почти не пользуются.
Ограничитель третий: организационный
Возвращаемся к соотношению 66 и 33 у MIT. Соблазн небольшой компании начать с уникальной разработки под себя в выборке MIT оказался вдвое менее успешным, чем адаптация готового.
Своё железо или облако: считаем
Локальное развёртывание обычно продают как способ сэкономить на подписках. Проверим.
Открытые модели, которые работают на одной видеокарте, существуют: семейства Gemma, Qwen, Phi покрывают диапазон от запуска на процессоре до 24 гигабайт видеопамяти (обзор на Hugging Face). Видеокарта с 16 гигабайтами в белорусской рознице на сентябрь 2026 года стоит порядка 2 700 рублей, рабочая станция вокруг неё обойдётся примерно в 5 500 рублей.
Сравниваем. 5 500 рублей это около 1 821 доллара. Если считать средний документ в 2 500 токенов (2 000 входных и 500 выходных), его обработка по тому же тарифу стоит 0,00185 доллара. На стоимость станции приходится около 985 тысяч документов. Фирма, обрабатывающая 200 документов в месяц, израсходует эту сумму за 410 лет.
Критерий | Своё оборудование | Облачный сервис |
|---|---|---|
Стартовые затраты | около 5 500 BYN | ноль |
Обработка 500 документов | электричество | около 2,79 BYN |
Трансграничная передача | не возникает | запрет с исключениями, нужно основание |
Риск отключения поставщиком | нет | есть |
Качество модели | ниже топовых | выше |
Обслуживание и обновления | ваша забота | поставщика |
Оговорка к таблице: в колонке своего оборудования не учтены настройка, обслуживание и амортизация, а они не нулевые. С их учётом разрыв ещё больше не в пользу железа.
Вывод прямой: своё железо покупают не ради экономии на вычислениях, потому что экономии там нет. Его покупают ради двух других вещей: данные физически не покидают периметр, и поставщик не может отключить вам процесс. В белорусских условиях обе причины весомые, но называть их экономией неправильно.
Если дело дойдёт до сборки такой станции, конфигурация подбирается под конкретную модель, а не наоборот: объём видеопамяти определяет, какая модель поместится. Мы собираем и обслуживаем технику для организаций, в том числе под эту задачу.
Где ИИ бесполезен или вреден
Задача выполняется реже раза в неделю. Настройка и отладка съедят больше, чем принесёт экономия.
Результат получен преобразованием, а не извлечением. Сметы, расчёты, прогнозы, финансовая отчётность: у ответа нет адреса в исходнике, и проверить его можно только повторив вычисление.
Нет входных данных в электронном виде. Если история продаж живёт в голове у владельца, прогноз строить не на чем. Сначала данные, потом модели.
Требуется юридическая ответственность за результат. Подпись под документом ставит человек, и он отвечает. Ускорение подготовки допустимо, замена ответственного нет.
Цель формулируется как «внедрить ИИ». Если задача не названа, считать нечего. Внедряют не технологию, а решение конкретной проблемы.
Как выбрать первую задачу
Шаг 1. Замерьте, куда уходит время. Неделю фиксируйте, сколько часов уходит на каждое регулярное действие. Записью, не по памяти. Результат обычно удивляет.
Шаг 2. Возьмите три самые объёмные задачи и прогоните через правило проверки. Сколько минут занимает сейчас, сколько займёт проверка, какая доля потребует правки. Посчитайте по формуле выше.
Шаг 3. Отсейте те, где есть персональные данные, если не готовы разбираться с юридической стороной. Начать с обезличенных задач быстрее и безопаснее.
Шаг 4. Проверьте, есть ли готовое решение под эту задачу, прежде чем заказывать разработку.
Шаг 5. Запустите параллельно со старым способом на один цикл. Так вы увидите реальную долю ошибок вместо оценочной и получите цифры для расчёта окупаемости.
И только после этого считайте окупаемость целиком. Сэкономленные часы сами по себе деньгами не становятся: как их превратить в деньги, разобрано в материале о расчёте окупаемости автоматизации. Правило проверки стоит на шаг раньше: сначала убедитесь, что часы освободятся, потом считайте, во что они превратятся.
Если не определились, какой процесс трогать первым, посмотрите пять типовых сценариев автоматизации: два из пяти там честно помечены как неокупаемые для небольшой фирмы.
Границы этого разбора
Опросы МАСМИ, БГЭУ и Бюро переписи США проведены по разным методикам, в разные годы и на разных выборках. Сопоставление показывает порядок величины, а не строгое сравнение.
Данные БГЭУ про 10 % процессов относятся к 2024 году и с тех пор не обновлялись.
Соотношение 66 и 33 у MIT получено на выборке интервью с корпоративными пилотами. Перенос этой пропорции на малый бизнес это допущение, а не установленный факт, хотя в статье он используется трижды.
Из трёх расчётов замером подкреплена одна величина: время ответа модели на запрос по документу, около четырёх минут вместе с чтением ответа. Остальные значения оценочные. Подставьте свои: формула для того и приведена.
Перенос результатов колл-центра на другие роли основан на объяснённом авторами механизме, но остаётся допущением.
Стоимость рабочей станции оценочная, цена видеокарты актуальна на сентябрь 2026 года.
Правовые нормы приведены по состоянию на 13 сентября 2026 года. Законопроект внесён в Совет Министров, финальный текст не опубликован.
Доступность конкретных сервисов из Беларуси меняется без предупреждения. Проверяйте на момент принятия решения.
Что дальше
Если у вас есть процесс, который отнимает часы каждую неделю, пришлите его описание в свободной форме: что делает человек, сколько времени занимает, откуда берутся данные. Разберём по правилу проверки и скажем прямо, попадает ли задача в список окупаемых, какой из семи типов ей подходит и есть ли там персональные данные, из-за которых придётся менять схему. Бесплатно, обычно отвечаем в течение рабочего дня. Подробнее об услуге: автоматизация бизнес-процессов.